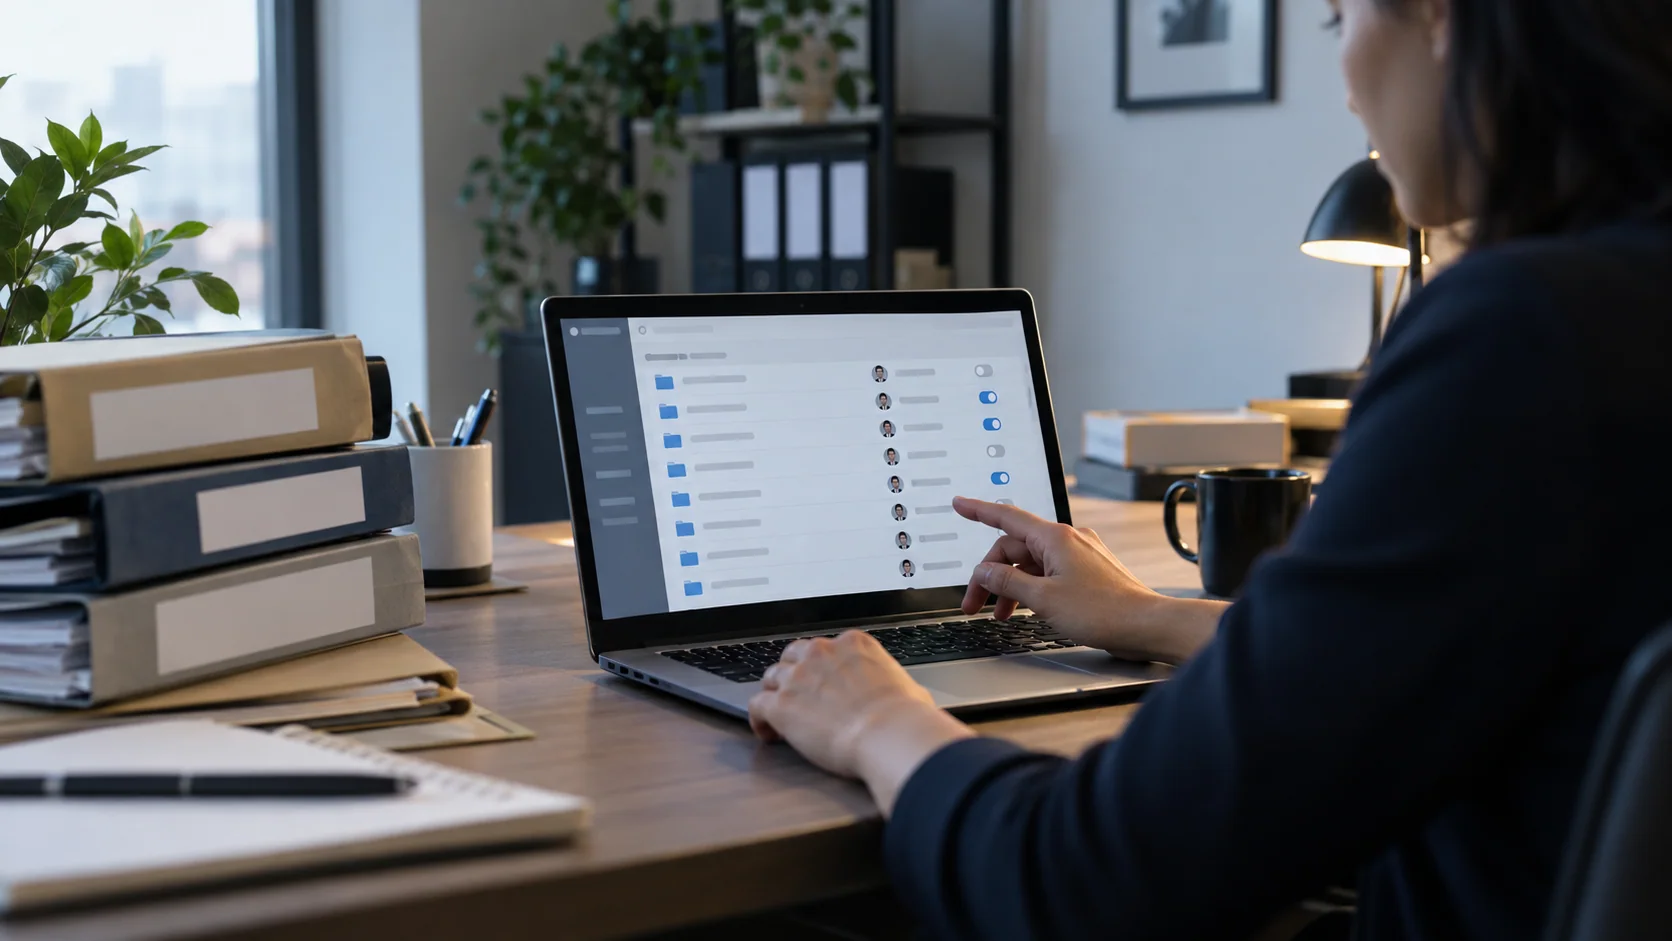
Per collegare un assistente AI ai documenti aziendali in modo controllabile, occorre mantenere i permessi effettivi di ogni persona anche durante la ricerca e la generazione della risposta. Una cartella condivisa non diventa adatta all'AI solo perché il connettore è autorizzato: vanno verificati identità, ambito dei file, indicizzazione, conservazione, registri e revoca degli accessi.
Disegnare il percorso del documento
Un sistema che risponde usando documenti può includere un connettore, un processo di estrazione del testo, un indice di ricerca o vettoriale, un livello di recupero delle fonti e il modello linguistico. In un flusso RAG (retrieval-augmented generation), il modello riceve porzioni recuperate dall'archivio al momento della domanda; la conoscenza non è necessariamente incorporata nel modello. Ogni passaggio crea una diversa superficie di accesso e conservazione.
- Identità: la persona o il servizio che effettua la richiesta e il tenant a cui appartiene.
- Origine: repository, cartelle e file ammessi, con proprietario e classificazione dei dati.
- Indice: identificativo del documento, versione, permessi applicabili e data dell'ultima sincronizzazione.
- Recupero: filtro dei risultati in base all'identità e agli ACL prima di inserire estratti nel contesto del modello.
- Risposta e azione: fonti restituite, dati registrati, eventuale approvazione prima di modificare o condividere un file.
Applicare i permessi anche alla ricerca RAG
Il controllo va applicato nel momento in cui si recuperano i documenti, non soltanto dopo che il modello ha composto una risposta. Un filtro tardivo non può rimuovere con certezza informazioni già passate al modello. L'indice dovrebbe associare ogni segmento al file d'origine e ai metadati di autorizzazione; il servizio di ricerca deve escludere documenti non accessibili all'utente richiedente prima del ranking e della costruzione del contesto. Se i permessi non possono essere sincronizzati o applicati con precisione, limitare il sistema a una raccolta separata con accessi già verificati.
Separare autenticazione e autorizzazione
L'autenticazione stabilisce chi sta facendo la richiesta; l'autorizzazione determina quali documenti quella persona può consultare. Il backend dovrebbe ricavare l'identità da una sessione verificata o da un token validato, poi applicare i permessi lato server. Non fidarsi di un indirizzo email o di un ruolo inviato dal browser come prova di accesso. In un sistema multi-tenant, associare ogni documento e richiesta a un tenant verificato, includere tenant e ambito d'accesso nelle chiavi di cache e separare gli indici quando il filtraggio incrociato non è garantito. Provare anche che le fonti citate nella risposta siano apribili solo da utenti già autorizzati.
Separare lettura, scrittura e identità di servizio
Concedere un'autorizzazione di sola lettura non dovrebbe implicare la possibilità di caricare, modificare, cancellare o condividere documenti. Usare un'identità di servizio dedicata, credenziali conservate in un secret manager e gli scope OAuth minimi; evitare token personali riutilizzati tra automazioni. Separare l'indice dei documenti dall'archivio originale aiuta anche a revocare un'integrazione senza dover ricostruire le autorizzazioni del drive.
Trattare indice, log e copie come dati aziendali
Prima di collegare i file, chiedere al fornitore se prompt, risposte, allegati, estratti e indici persistono, per quanto tempo, in quale regione e con quali ruoli amministrativi. Distinguere la conservazione dall'addestramento: una garanzia di non usare i dati per addestrare modelli non significa necessariamente che prompt o registri non vengano conservati. I log diagnostici dovrebbero contenere identificativi di correlazione e metadati utili, evitando il testo integrale dei documenti quando non serve.
Gestire revoca, cancellazione e prompt injection
Se un dipendente perde accesso a un file, se il file viene cancellato o se il connettore viene disattivato, l'indice deve ricevere la modifica entro un intervallo definito e la ricerca deve smettere di restituire quel contenuto. Verificare il comportamento con account di ruoli diversi e con un documento di prova. I testi recuperati sono dati non attendibili: una frase nel file che invita il modello a ignorare le istruzioni o a inviare informazioni può essere un tentativo di prompt injection. Il recupero di contenuti non deve poter ampliare da solo i permessi o autorizzare azioni esterne.
Registrare quale versione del documento ha alimentato ogni segmento, quando è stato aggiornato l'indice e quale fonte è stata usata per la risposta. Quando il file cambia, rimuovere o sostituire i segmenti vecchi e verificare che una cache non continui a servire il risultato precedente. Per materiali soggetti a cancellazione o a tempi di conservazione, documentare come si propagano la cancellazione e la scadenza a indice, cache e log; chiedere al fornitore che cosa avviene anche per copie di sicurezza e dati di telemetria.
Preparare un piccolo set di regressione con domande a cui si conosce la risposta e il documento atteso, incluse domande senza una fonte autorizzata. Dopo modifiche a chunking, embedding, filtri o permessi, controllare sia la pertinenza del recupero sia l'isolamento degli accessi. Una risposta plausibile ma basata sul file sbagliato resta un errore; rendere visibile la fonte ai revisori aiuta a intercettarlo prima che l'output venga riutilizzato.
Checklist prima di attivare il connettore
- Definire cartelle consentite e categorie escluse, comprese credenziali e documenti HR o finanziari non necessari.
- Provare con un utente autorizzato e uno non autorizzato, verificando che il secondo non trovi né riassuma il documento.
- Controllare conservazione, uso dei dati, amministratori, subfornitori, esportazione e cancellazione nel piano effettivamente acquistato.
- Verificare che lettura, modifica e invio siano permessi distinti e che gli output restino in revisione quando serve.
- Provare rimozione di un file, cambio ACL, revoca del token e procedura per interrompere il flusso.
OWASP segnala tra i rischi per le applicazioni LLM la divulgazione di informazioni sensibili, la prompt injection, l'eccesso di autonomia e le debolezze di vettori e embedding. Il NIST AI RMF aiuta a organizzare governance, contesto, misurazione e gestione del rischio lungo il ciclo di vita. Sono riferimenti per strutturare una verifica, non certificazioni automatiche né sostituti di una valutazione contrattuale o legale.